scariv_topがどのモジュール単体よりも遅い状態が続いていた。
| モジュール | fmax |
|---|---|
| scariv_iq | 206.8 MHz |
| scariv_rob | 100.3 MHz |
| scariv_lsu | 152.5 MHz |
| scariv_top | 51.6 MHz |
IQが命令を選んでからPRFに書き戻るまで、途中にレジスタが1本もない。 合成では縮まない種類の問題で、26回目から毎回「次」に挙げて先送りしていた。
パスの内訳
topのクリティカルパス19.4 nsを測ると、こうなっていた。
| 区間 | 時間 | 中身 |
|---|---|---|
| 0 - 4.15 ns | 4.15 | IQの選択論理、約20段 |
| 4.15 - 14.97 ns | 10.82 | バッファ24段 |
| 14.97 - 19.4 ns | 4.4 | PRF書き込みまでの論理 |
真ん中の10.8 nsが全段ファンアウト16のバッファだった。
bufferを完全に外して素のファンアウトを数えると、原因が見える。
  1155  u_iq.r_iq_..._and2_2_B_X
  1065  u_iq.r_iq_..._nand2_1_B_Y
  1027  u_iq.r_iq_..._o21ai_4_A2_Y
u_iqに700から1150負荷のネットが十数本ある。
scariv_iq単体では206.8 MHzで、同じ信号はモジュール境界で止まって負荷1になる。
topでフラット化されると、PRFの読み出しデコードと実行ユニットまで1本の信号が直接届く。
ファンアウト1000は設計がそう要求しているのではなく、段が無いせいだった。
段を切る
選択と実行の間に1本入れる。 4.15 nsと4.4 nsなので、ほぼ半分で切れる。
| 段 | 内容 |
|---|---|
| S | IQが選ぶ |
| X | PRF読み出し、実行、writeback |
| M | ロードのみ。TCMのデータが返る |
どこに置くか
最初、scariv_topに発行レジスタを置く案を出した。
topは配線だけを持つ場所で、パイプラインを置くところではない、という指摘を受けて考え直した。 IQに入れるのが正しい。
  assign w_s_valid [p] = |w_iss_slot_oh[p] & i_iss_ready[p];
  assign w_s_uop   [p] = r_iq[w_iss_idx[p]].uop;

  always_ff @ (posedge i_clk, negedge i_rst_n) begin
    ...
    end else if (i_iss_ready[p]) begin
      o_iss_valid [p] <= w_s_valid[p];
      o_iss_uop   [p] <= w_s_uop[p];
    end
  end
ポート名も向きも変わらない。
o_iss_*がS段の値からX段の値になるだけで、topの変更は1行で済んだ。
最初の案では「差し替え十数箇所」を見積もっていた。 置き場所を間違えると作業量まで変わる。
wakeupをどうするか
素直に段を分けると、依存命令が毎回1サイクル空く。 wakeupがwritebackで起きるので、結果が1サイクル遅れるぶんそのまま伝わる。
選択時にタグを配れば解ける。
  N    A: 選択、prdをタグとして配る   B: wakeup
  N+1  A: 実行+wb                    B: 選択
  N+2  A: PRF書き込み完了            B: 実行 (PRFからAの値を読む)
AのPRF書き込みがN+1の終わりに確定し、BのPRF読み出しがN+2なので、ちょうど間に合う。 26回目に「段を分けるならbypass網が要る」と書いたが、レイテンシが固定ならタグの前倒しだけで足りる。
今回はここまで入れていない。 レジスタだけ入れて、wakeupはwritebackのままにした。
この状態は単独で正しい。 依存命令が1サイクル損するだけで、間違った値は読まない。 次にタグを前倒ししてバグが出たとき、レジスタ側は正しいと分かっているので切り分けられる。
出てきたバグ
2つ出た。 どちらも波形で原因を確定させた。
ストアがwritebackを失う
rv64ui-p-st_ldとld_stが落ちた。
LSUのwritebackポートは1本で、M段のロードが使う。
    if (r_ld_pending) begin
      ...                              // ロードの結果
    end else if (w_iss_is_store) begin
      ...                              // ここに来られない
新しく書いたo_x_holdが、r_ld_pendingをロードの枝にしか入れていなかった。
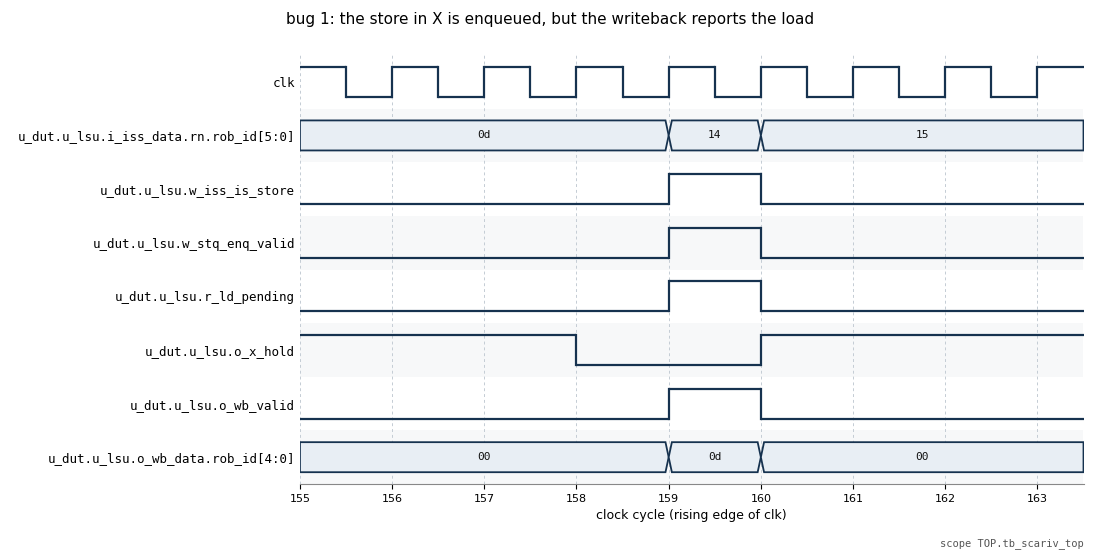
サイクル159でX段に居るのはrob_id 0x14のストアで、w_iss_is_storeとw_stq_enq_validが立ってSTQに積まれる。
r_ld_pendingが高いのでo_wb_data.rob_idは0x0d、M段のロードを指す。
o_x_holdは低いので、サイクル160でストアはX段を去る。
ストアはSTQに積まれてX段を去るのに、writebackはロードを報告する。
ROBは0x14のdoneを永久に立てない。
分割前のコードは条件を全体に掛けていた。
assign o_iss_ready = (r_ld_pending == 1'b0) && ( ... );
この&&を、holdに書き換えるときに落としていた。
IQの空き数が多重加算される
ld_stが535命令で止まる。
ROB headのauipcがdoneにならず、その命令はIQにも居ない。
空き数は差分で持っている。
  assign w_iss_valid_packed[p_idx] = o_iss_valid[p_idx];
  r_remain_entries <= r_remain_entries - w_dis_num + w_iss_num;
エントリを解放するのはS段だが、o_iss_validはX段で、X段で止まっている間ずっと立ち続ける。
1つ解放したエントリが、止まったサイクル数だけ加算される。
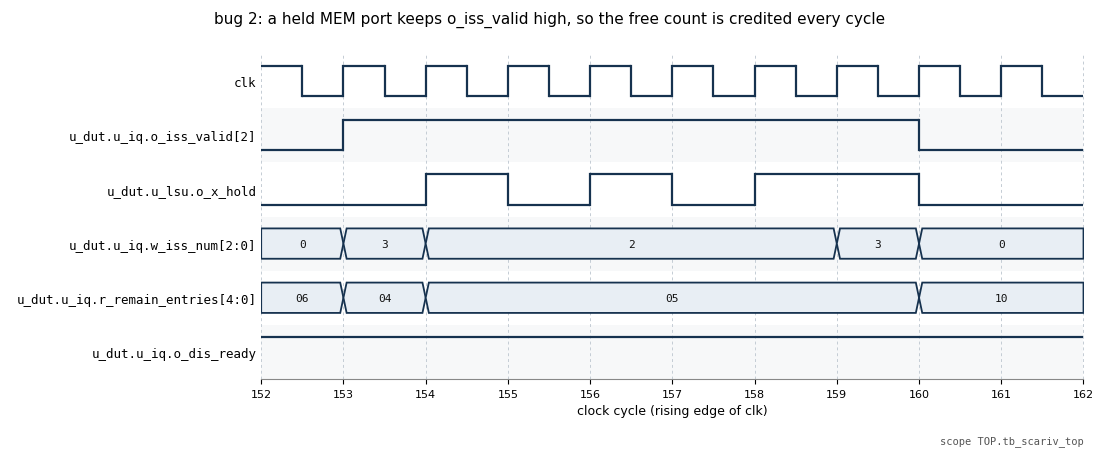
o_iss_valid[2]はサイクル153から160まで高いままで、o_x_holdがその間トグルしている。
ロードは1本しか居ないのに、w_iss_numはずっと2か3を数える。
r_remain_entriesは05から10、つまり16まで上がる。
IQはまだ埋まっているのに空き16と信じる。
o_dis_readyが立ちっぱなしになり、空きスロットの無いままdispatchを受けて、命令をどこにも書かずに落とす。
S段のパルスを数えるように直した。
波形を画像にした
どちらも29回目に作ったツールで出した。 GTKWaveは開いていない。
make WAVE=1 COSIM=1 build-top
./obj_dir_top/tb_scariv_top +hex=... +wave=w.vcd
tools/wave2img.py w.vcd --from 1555000 --to 1640000 --clock '*.clk' \
  -s '*u_lsu.w_iss_is_store' -s '*u_lsu.r_ld_pending' ... -o bug.png
2つめのバグを追うとき、最初は「ROBとIQが別々のreadyでdispatchしている潜在バグがある」と考えて、そう報告した。
波形を見たら違った。
w_dis_iq_validはw_iq_dis_readyと連動していて、ROBは過剰にdispatchしていない。
推測で書いたものだった。 波形で潰せたのはよかった。
ツール側のバグも1つ出た。
foo[2]のような添字付きの信号に当たらない。
fnmatchが[2]を文字クラスとして読むためで、*と?だけをワイルドカードにする形に直した。
測ったら悪くなっていた
ここからが本題になる。
分割して合成すると、scariv_topが51.6 MHzから27.4 MHzになった。
論理を短くしたのに、数字は半分近くまで落ちた。
クリティカルパスの起点が発行レジスタの出力で、Qの遷移だけで29.17 nsかかっていた。
   904  dfxtp_1  u_csr.i_iss_data[146]
   865  dfxtp_1  u_iq.o_iss_uop[450]
   614  dfxtp_1  u_csr.i_iss_data[147]
34回目に分離した課題がそのまま効いていた。
| 負荷の居場所 | abcが触れるか | |
|---|---|---|
| 分割前 | 組合せ網の中 | 触れる (24段の鎖を作る) |
| 分割後 | フリップフロップの出力 | 触れない |
分割は正しかったのに、バッファできる場所にあった負荷を、できない場所へ移していた。 段を1つ増やす変更は、定義上この問題を最も強く受ける。
34回目で「残りはフリップフロップ出力側で、resizerが要る」と書いて課題に分離し、そのまま先へ進んだ。 順番が逆だった。
26回目に3回数えた「測りたいものを測れていない」の、4回目になる。
resizerを入れる
abcの設定は34回目に4通り試して、鎖はO(N)なので縮まないことを確認済みだった。
残る手はresizerしかない。
OpenROADのrepair_designを合成フローに足した。
やることは物理設計側へ一段進む。 フロアプランを作り、配置し、配置から寄生容量を見積もって、初めてresizerが問題を見られる。
initialize_floorplan -die_area [list 0 0 $side $side] ...
source synth/pdk/sky130hd/make_tracks.tcl
place_pins -hor_layers met3 -ver_layers met2
global_placement -density 0.6 -skip_initial_place
estimate_parasitics -placement
repair_design
最初estimate_parasiticsを入れずに走らせたら、4バッファ挿入してslackが悪化した。
[WARNING EST-0027] no estimated parasitics. Using wire load models.
配置が無ければ寄生容量も無く、resizerには見るものが何も無い。
数字が全部変わる
実配線RCが入ると、同じネットリストの評価が変わる。
| 理想配線 | 推定配線 | |
|---|---|---|
| scariv_top、repair前 | 51.6 MHz | -238 nsのslack |
| scariv_top、repair後 | - | 31.6 MHz |
1000負荷のフリップフロップ出力は、理想配線では7.69 nsだったが、実際のRCでは桁が違う。
repair_designはtopで4322セットをupsizeし、3310バッファを挿入する。
差のほとんどはresizerがabcの届かないところを直したぶんになる。
19モジュールで5分38秒なので、回帰に残せる。
ようやく比べられた
同じフローで分割前と分割後を測る。
| 分割前 | 分割後 | |
|---|---|---|
| repair前 slack | -238.21 ns | -238.95 ns |
| repair後 slack | -39.25 ns | -30.41 ns |
| 挿入バッファ | 2,667 | 3,310 |
| upsize | 3,715 | 4,322 |
分割後の方が8.8 ns速い。
scariv_topで24.9から31.4 MHz、1.26倍になる。
abcだけの数字では悪化、resizerを入れると改善。
同じRTLで結論が逆になる。
細かいところ
フローを2イメージに分けた。
OpenROADはUbuntu 22.04でビルドされていてGUI用のX11/Qtを丸ごと引く。 こちらの24.04イメージへバイナリをコピーするのはABIの賭けになるので、上流のイメージのまま呼ぶことにした。 PDKのファイルだけホストに出して、両方から同じ相対パスで読む。
ダイのサイズは2つの要求の大きい方で決めた。
ロジックのあるモジュールは利用率で決まるが、小さくて端子の多いモジュールは外周で決まる。
scariv_renameは201 um2のロジックに905ポートで、利用率40%のダイには86本しか置けない。
bit_reverseとbit_rotate_leftはセルに1つもマップされない。
配線の並べ替えだけなので、フロアプランを作る対象が無く、物理の段を飛ばしている。
run_all.shが1モジュールで止まるようになった。
docker run -iが標準入力を食べていて、それがモジュール一覧だった。
次
- タグを選択時に配って、依存命令の間隔を1サイクルに戻す
この連載の記事一覧: RISC-V OoO CPUを実装する 記事一覧
