前回の記事:msyksphinz.hatenablog.com
前回までで、1つのwarpが分岐で割れても正しく動くコアができた。 今回はwarpを複数にする。 GPUがメモリレイテンシを隠す仕組み、すなわちwarpスケジューリングを実装する。
GPUの速さはレイテンシを埋めることにある
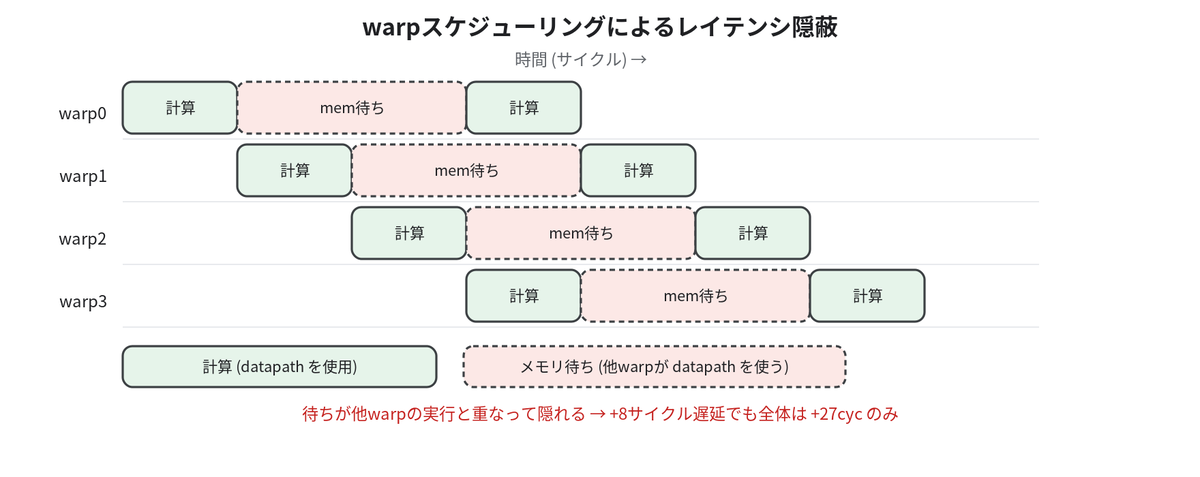
CPUは、キャッシュでメモリアクセスの待ち時間そのものを短くしようとする。 GPUの戦略は違う。 あるwarpがメモリ待ちで止まっているあいだ、別のwarpを実行する。 待ち時間を消すのではなく、別の仕事で埋める。 この埋め草となるwarpを多数抱えることが、GPUの高い実効スループットを支えている。
そこで本コアは、warpごとに独立したコンテキストを持ち、毎サイクル実行可能なwarpを1つ選んで進める。 1サイクルに1warpずつ切り替えながら走らせる、いわゆるバレル方式である。
warpごとに複製するもの
warpを増やすとき、何をwarpごとに持つかを決める。
- warpごとに複製:SIMTスタック(PC、RPC、マスク)、レジスタファイル、ロード結果バッファ、FSMの状態、メモリ待ちカウンタ
- 全warpで共有:命令デコード、ALU、メモリポート
Phase 3で1本だったSIMTスタックとレジスタファイルを、warpの数だけ並べる。
具体的には、これらの配列に warp 次元 [NWARP] を1つ足す。
state_e            wstate  [NWARP];          // warp ごとの FSM 状態
logic [31:0]       st_pc   [NWARP][DEPTH];   // SIMTスタック: PC
logic [31:0]       st_rpc  [NWARP][DEPTH];   //              合流PC (RPC)
logic [NLANE-1:0]  st_mask [NWARP][DEPTH];   //              アクティブマスク
logic [SPW-1:0]    sp      [NWARP];          // スタックポインタ
logic [15:0]       memcnt  [NWARP];          // メモリ待ちカウンタ
logic [31:0]       xr      [NWARP][NLANE][REGS];   // レジスタファイル
一方、デコードやALUといった演算回路は1系統を時分割で使う。
毎サイクル、スケジューラが選んだwarp cw の文脈で、この共有回路を駆動する。
現在のPCやマスク、レジスタ値は、cw とそのスタックポインタ sp[cw] で引く。
logic [SPW-1:0]   c_sp;   assign c_sp   = sp[cw];
logic [31:0]      cur_pc; assign cur_pc = st_pc[cw][c_sp];   // 選ばれた warp の PC
logic [NLANE-1:0] active; assign active = st_mask[cw][c_sp]; //            マスク
assign rv1[g] = xr[cw][g][rs1];                              //            オペランド
ラウンドロビンのスケジューラ
スケジューラは、実行可能なwarpの中から次の1つを選ぶ。 実行可能とは、停止しておらず、かつメモリ待ちでもないことである。
for (int w = 0; w < NWARP; w++)
  ready[w] = (wstate[w] != S_IDLE) && (wstate[w] != S_HALT)
             && !((wstate[w] == S_MEMWAIT) && (memcnt[w] != 0));
選び方はラウンドロビンとした。 直前に選んだwarpの次から順に探し、最初に見つかった実行可能なwarpを選ぶ。
cw = last_w; cw_valid = 1'b0;
for (int i = 1; i <= NWARP; i++) begin
  int unsigned idx = int'(last_w) + i;
  if (idx >= NWARP) idx = idx - NWARP;
  if (!cw_valid && ready[idx[WIDW-1:0]]) begin
    cw = idx[WIDW-1:0]; cw_valid = 1'b1;          // 最初の ready を採用
  end
end
選ばれたwarpを1ステップ進める
本体の always_ff は、2つの仕事をする。
1つは、全warpのメモリ待ちカウンタを毎サイクル減らすこと。
もう1つは、スケジューラが選んだ1つのwarpだけ、FSMを1ステップ進めることである。
always_ff @(posedge clk) begin
  // (1) 全 warp: メモリ待ちを自由に減らす (実行とは独立に時間が進む)
  for (int w = 0; w < NWARP; w++)
    if (wstate[w] == S_MEMWAIT && memcnt[w] != 0) memcnt[w] <= memcnt[w] - 16'd1;

  // (2) 選ばれた warp だけ FSM を1ステップ進める
  if (cw_valid) begin
    last_w <= cw;
    unique case (wstate[cw])
      S_FETCH: begin insn[cw] <= mem_rdata; wstate[cw] <= S_EXEC; end
      S_EXEC : begin /* デコードして演算・分岐・メモリへ振り分け */ end
      S_LSU  : begin                      // ロード/ストアを終えたら待ちへ
        if (c_li == LW'(NLANE-1)) begin
          memcnt[cw] <= MEMLAT[15:0];
          wstate[cw] <= (MEMLAT == 0) ? S_WB : S_MEMWAIT;
        end else li[cw] <= c_li + LW'(1);
      end
      S_MEMWAIT: if (memcnt[cw] == 0) wstate[cw] <= S_WB;
      // ... S_SCHED / S_WB / S_HALT
    endcase
  end
end
ここが本コアの心臓部である。
状態は wstate[cw] のように warp ごとに分かれているので、選ばれていないwarpはその場で凍結される。
選ばれたwarpだけが1ステップ進み、次のサイクルには別のwarpが選ばれる。
warpを切り替えながら、共有の演算回路を時分割で使い回しているわけである。
分岐が割れた warp はどうなるか
上の S_EXEC の中身は省いたが、ここにはPhase 3で作った分岐ダイバージェンスの処理が入っている。
今回の題材は直線コードなので割れないが、Phase 3のようなガード付きカーネルを多warpで走らせると、各warpで分岐が割れる。
そのとき何が起きるかを押さえておく。
割れるのは warp の中だけ
Phase 3のスタック操作は、Phase 4でもそのまま使う。
変わったのは、操作する配列に warp 次元 [cw] が付いたことだけである。
選ばれた warp cw が割れると、S_EXEC でその warp 自身のスタックに3エントリを積む。
// S_EXEC のダイバージェンス: cw 自身のスタックだけを操作する
st_pc[cw][sp[cw]]       <= br_target;                                   // merge (分岐先で待つ)
st_mask[cw][sp[cw]+1]   <= taken_v;          st_pc[cw][sp[cw]+1] <= br_target;  // taken
st_mask[cw][sp[cw]+2]   <= active & ~taken_v; st_pc[cw][sp[cw]+2] <= seq_pc;    // not-taken
sp[cw]                  <= sp[cw] + SPW'(2);
スタックも sp も warp ごとなので、割れるのは cw の中だけである。
他の warp のスタックやマスクには一切触れない。
割れた warp は本体(not-taken)と taken の両経路を順に実行するので、S_HALT に着くまで余計なFSMステップを踏む。
スケジューラは、その余分なステップを他のwarpのステップと交互に進めるだけで、特別扱いはしない。
再収束も warp ごとで、S_SCHED で cur_pc がそのエントリの cur_rpc に達したら pop する。
割れたまま warp がロードすると
割れて active が一部の lane だけになった状態で、その warp がロードやストアを実行すると、メモリの直列化が表に出る。
本コアのメモリポートは1本で、S_LSU は lane を 0 から NLANE-1 まで無条件に1つずつ回す。
各 lane の読み書きだけを、マスク active[c_li] でゲートする。
assign mem_we = (wstate[cw]==S_LSU) && is_store && active[c_li];   // ストアは active な lane だけ

S_LSU: begin
  if (is_load && active[c_li]) ld_data[cw][c_li] <= mem_rdata;     // ロード取り込みも active だけ
  if (c_li == LW'(NLANE-1)) ... else li[cw] <= c_li + LW'(1);      // ループはマスクを飛ばさず全 lane を回る
end
有効な lane は、自分のアドレスを出して読み書きし、S_WB でレジスタに結果を書く。
マスクされた lane は、mem_we が0で取り込みもなく、レジスタも更新されない。
ただし lane を回すループはマスクを飛ばさないので、マスクされた lane も1サイクルずつ番を消費する。
つまり、8 lane のうち5 lane だけ有効なロードでも、8サイクルかかる。
残り3 lane のぶんが、空転として無駄になる。
これが、ダイバージェンスとメモリが重なったときのSIMTの非効率である。
なお、割れた lane はアドレスを計算する命令を飛ばしているので、その実効アドレスは古い値になる。
しかし mem_we が0で結果も取り込まないので、害はない。
この「マスクされても1 lane が1サイクル」という素朴さは、次のPhase 5のコアレッシングで一段だけ和らぐ。 連続判定を有効な lane のアドレスだけで行い、書き込みマスクで穴を表すので、割れていても有効 lane が連続なら1トランザクションに束ねられる。
メモリレイテンシを「デスケジュール」で表す
レイテンシ隠蔽を観察するには、メモリに遅延が要る。
本コアでは、ロードのデータ移動そのものは1サイクルで済ませ、遅延は待ち状態 S_MEMWAIT として別に表した。
ロードを終えたwarpは MEMLAT サイクルの待ちに入る。
重要なのは、上の always_ff の (1) にあるとおり、この待ちカウンタがスケジュールとは無関係に毎サイクル減ることである。
あるwarpが待っているあいだ、スケジューラは他のwarpを動かす。 待ち時間は他のwarpの実行と重なって過ぎていく。 これが隠蔽の正体である。 カウンタが0になったwarpはふたたび実行可能になり、ロード結果をレジスタへ書く。
実行結果
NWARP=4、NLANE=8 とし、32要素のベクトル加算を走らせた。
warp w のlane t が要素 i = w*8 + t を担当する。
担当の決定には、warp idを返すCSR WID を使う。
メモリレイテンシ MEMLAT を0と8に変えてビルドし、サイクル数を比べる。
$ cd sim && make mwarp
--- MEMLAT=0 (レイテンシ無し) ---
cycles = 268
全 32 要素 一致
--- MEMLAT=8 (隠蔽されるはず) ---
cycles = 295
全 32 要素 一致
注目するのはサイクル数の増え方である。 ロードは1warpあたり2回、4warpで合計8回ある。 各ロードに8サイクルの遅延を足したので、隠蔽が無ければ単純計算で64サイクル前後が上乗せされるはずである。 ところが実際の増加は27サイクル(268から295)にとどまった。 差の大半が、他のwarpの実行と重なって隠れたことになる。 warpを増やすほど隠せる待ちも増える、という関係がここに現れている。
